Crawling Nedir? robots.txt, E-E-A-T ve Yapay Zeka SEO
Crawling nedir, arama motoru ve yapay zeka botları web sitelerini nasıl tarar? robots.txt hatalarını, noindex farkını, Google E-E-A-T yaklaşımını, kırık bağlantı kontrollerini ve Wikipedia, Reddit, Quora gibi platformların marka itibarındaki rolünü ayrıntılı biçimde anlatıyoruz.
Crawling Nedir? robots.txt, Google E-E-A-T ve Yapay Zeka Botları İçin Kapsamlı SEO Rehberi
Bir web sitesinin Google arama sonuçlarında veya yapay zeka destekli arama sistemlerinde görünür olabilmesi için öncelikle ilgili sistemlerin o web sitesindeki bilgilere ulaşabilmesi gerekir. Ancak birçok işletme içerik üretimine, anahtar kelime araştırmasına ve SEO çalışmalarına yatırım yaparken web sitesinin arama motorları tarafından gerçekten taranıp taranamadığını yeterince incelemez.
Oysa arama motorlarının ve web üzerinde bilgi toplayan yapay zeka sistemlerinin çalışma biçimlerini anlamak, başarılı bir dijital görünürlük stratejisinin önemli parçalarından biridir.
Web sitelerindeki sayfaların keşfedilmesi ve taranması sürecine crawling, yani web tarama adı verilir. Bu süreçte otomatik yazılımlar internet üzerindeki bağlantıları takip ederek sayfalara ulaşır, erişebildikleri içerikleri inceler ve çeşitli bilgiler toplar.
Ancak bir web sitesinin taranabilir olması, o sitenin Google'da mutlaka üst sıralarda yer alacağı veya ChatGPT gibi yapay zeka sistemlerinde önerileceği anlamına gelmez.
Taranabilirliğin yanında teknik SEO, içerik kalitesi, güvenilirlik, uzmanlık ve markanın internet üzerindeki itibarı da değerlendirilmesi gereken konular arasında bulunur.
Bu noktada robots.txt dosyası, Google E-E-A-T yaklaşımı, site dışı marka görünürlüğü ve kullanıcılar tarafından oluşturulan içerikler önem kazanır.
Peki crawling nedir, arama motoru botları web sitelerini nasıl tarar, robots.txt dosyasında yapılan hatalar nelerdir ve bir işletme internette güvenilir bir marka kimliğini nasıl geliştirebilir?
Bu rehberde web sitesi taramasının teknik yapısını, yaygın SEO hatalarını, Google E-E-A-T kavramını ve Wikipedia, Reddit, Quora gibi platformların dijital marka görünürlüğündeki rolünü ayrıntılı biçimde inceleyeceğiz.
Crawling Nedir? Web Sitesi Tarama Ne Anlama Gelir?
Crawling, arama motorlarının ve diğer otomatik bilgi toplama sistemlerinin internet üzerindeki web sayfalarını keşfetmek ve içeriklerini incelemek amacıyla gerçekleştirdiği tarama işlemidir.
Bu işlem, crawler veya web crawler olarak adlandırılan yazılımlar tarafından yürütülür.
Türkçede bu yazılımlar için web tarayıcı botu, arama motoru botu veya örümcek bot ifadeleri kullanılabilir.
Google'ın web sayfalarını taramak için kullandığı Googlebot, bu tür yazılımların en bilinen örneklerinden biridir.
Bir web tarayıcı botu belirli bir sayfaya ulaştığında, teknik erişim koşullarına bağlı olarak sayfanın HTML içeriğini ve ilgili kaynaklarını inceleyebilir.
Ardından sayfada bulunan bağlantıları keşfederek diğer adreslere ulaşmaya çalışabilir.
Bu süreç, internet üzerindeki web sayfalarının birbirine bağlandığı yapının keşfedilmesine yardımcı olur.
Web Tarayıcı Botları Nasıl Çalışır?
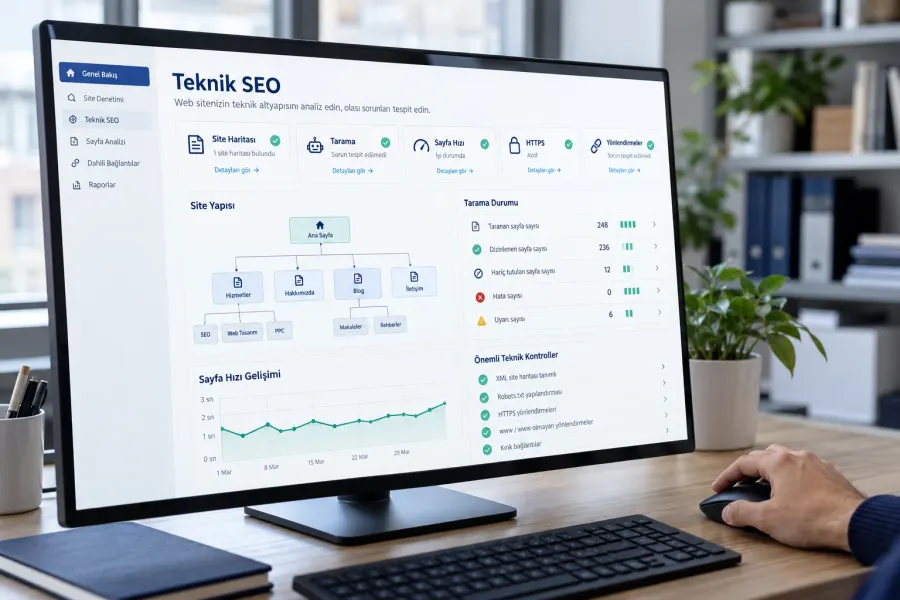
Bir web tarayıcı botunun çalışma mantığını anlamak için basit bir web sitesi düşünelim.
Bu web sitesinde ana sayfa, Hakkımızda, hizmetler, blog ve iletişim sayfaları bulunsun.
Tarayıcı bot ana sayfaya ulaştığında sayfanın içeriğini inceleyebilir. Daha sonra ana sayfada bulunan bağlantıları tespit ederek diğer sayfalara geçebilir.
Örneğin ana sayfada hizmetler bölümüne yönlendiren bir bağlantı varsa bot bu bağlantıyı takip edebilir.
Hizmetler sayfasında kurumsal web sitesi tasarımı, e-ticaret sitesi kurulumu ve SEO danışmanlığı gibi farklı hizmetlere ait sayfalar bulunabilir.
Bot bu bağlantıları da keşfederek web sitesi içerisindeki diğer içeriklere ulaşabilir.
Benzer şekilde blog sayfasında bulunan makale bağlantıları aracılığıyla bilgilendirici içerikler keşfedilebilir.
Bu işlem sayesinde botlar, web sitesindeki sayfaların birbirleriyle nasıl ilişkili olduğunu ve hangi konuların ele alındığını inceleme fırsatı bulur.
Ancak her botun aynı sayfaları aynı sırayla taradığı düşünülmemelidir. Tarama davranışı, kullanılan sistemin özelliklerine ve web sitesinin teknik durumuna göre değişebilir.
Crawling, Indexing ve Ranking Arasındaki Farklar
SEO çalışmalarında sıklıkla karşılaşılan üç kavram crawling, indexing ve ranking olarak adlandırılır.
Bu kavramlar birbirleriyle ilişkili olsa da aynı işlemi ifade etmez.
Crawling (Tarama): Bir arama motorunun web sayfasını keşfetmesi ve erişebildiği içeriği incelemesi sürecidir.
Indexing (Dizine ekleme): Arama motorunun değerlendirdiği sayfaya ait bilgileri arama dizinine dahil etmesi sürecidir.
Ranking (Sıralama): Belirli bir arama sorgusu için uygun görülen sonuçların çeşitli değerlendirmeler sonucunda sıralanmasıdır.
Bir sayfanın taranmış olması, mutlaka dizine eklendiği anlamına gelmez.
Aynı şekilde dizine eklenen bir sayfanın belirli bir anahtar kelimede üst sıralarda yer alacağı garanti edilemez.
Örneğin yeni yayımlanan bir blog yazısı Googlebot tarafından ziyaret edilmiş olabilir. Ancak Google, sayfanın içeriğini ve diğer koşulları değerlendirdikten sonra dizine eklememeyi tercih edebilir.
Sayfa dizine eklense bile ilgili sorgularda yeterince görünür olmayabilir.
Bu nedenle web sitesi sahiplerinin tarama, indeksleme ve sıralama süreçlerini ayrı ayrı değerlendirmesi gerekir.
Yapay Zeka Botları Web Sitelerini Nasıl Tarar?
Yapay zeka destekli arama sistemleri de internet üzerindeki bilgilere ulaşmak için farklı yöntemlerden yararlanabilir.
Bazı sistemler web arama araçları ve tarama altyapıları kullanarak güncel sayfalara erişebilir.
Bazıları ise belirli görevlerde daha önce edinilmiş model bilgileriyle cevap oluşturabilir.
Bu nedenle bütün yapay zeka uygulamalarının her kullanıcı sorusunda interneti yeniden taradığını düşünmek doğru değildir.
Ayrıca yapay zeka sistemlerinin kullandığı web tarayıcıları ile modellerin eğitiminde kullanılan veri toplama süreçleri birbirinden farklı olabilir.
Bir web sayfasının belirli bir yapay zeka botu tarafından taranması, sayfadaki bütün bilgilerin bir modele kalıcı olarak öğretildiği anlamına gelmez.
Bununla birlikte web sitelerinin teknik açıdan erişilebilir olması, internet üzerinde bilgi arayan sistemlerin ilgili sayfalara ulaşabilmesi açısından önem taşır.
Yapay Zeka Sistemleri Hangi Sayfalara Ulaşmalıdır?
Bir işletmenin bütün web sayfaları aynı derecede önemli olmayabilir.
Örneğin geçici kampanya sayfaları, eski duyurular veya yalnızca belirli işlemler için kullanılan teknik sayfalar, işletmenin temel faaliyetlerini açıklamayabilir.
Buna karşılık bazı sayfalar işletmenin dijital kimliğinin anlaşılmasında önemli rol oynar.
Bunlar arasında ana sayfa, Hakkımızda sayfası, temel hizmet sayfaları, ürün açıklamaları, iletişim bilgileri ve uzmanlık alanlarını anlatan içerikler bulunabilir.
Örneğin bir web tasarım şirketinin ana sayfasında yalnızca kısa bir tanıtım cümlesi bulunuyor ancak ayrıntılı hizmet açıklamaları farklı sayfalarda yer alıyorsa bu sayfaların keşfedilebilir olması önemlidir.
Benzer şekilde bir üretim firmasının ürün malzemelerini, üretim yöntemlerini ve kullanım alanlarını açıklayan sayfaları erişilebilir durumda olmalıdır.
Bu sayfaların taranabilirliği, otomatik sistemlerin işletmenin faaliyet alanlarıyla ilgili daha fazla bilgi keşfetmesini destekleyebilir.
Web Sitesinin Taranabilir Olması Neden Önemlidir?
Bir işletme kaliteli içerikler hazırlamış olabilir. Ancak bu içeriklere arama motorlarının ulaşmasını engelleyen teknik sorunlar varsa yapılan çalışmaların etkisi sınırlanabilir.
Örneğin web sitesinin Hakkımızda sayfasında işletmenin uzun yıllara dayanan gerçek deneyimleri anlatılıyor olabilir.
Fakat bu sayfanın bağlantısı yanlış hazırlanmışsa veya botların erişimi engellenmişse ilgili sistemler sayfayı tarayamayabilir.
Benzer şekilde bir işletmenin sunduğu önemli hizmetlerden biri web sitesinin diğer sayfalarından tamamen kopuk durumda olabilir.
Böyle bir sayfanın keşfedilmesi zorlaşabilir.
Ancak bir sayfaya ana sayfadan tıklanarak ulaşılamaması, arama motorlarının o sayfayı hiçbir şekilde keşfedemeyeceği anlamına gelmez. Botlar XML site haritaları, başka web sitelerinden verilen bağlantılar ve farklı keşif yöntemleri aracılığıyla da URL'lere ulaşabilir.
Bununla birlikte önemli sayfaların mantıklı bir site mimarisi içerisinde birbirine bağlanması, hem ziyaretçilerin gezinmesini kolaylaştırır hem de tarama süreçlerini destekler.
Web Sitesinin Taranabilirliği Nasıl Kontrol Edilir?
Web sitesi taranabilirliğini kontrol etmek için ilk aşamada karmaşık yazılımlar kullanmak zorunlu değildir.
Özellikle az sayıda sayfası bulunan web sitelerinde temel kontroller manuel olarak yapılabilir.
İlk olarak web sitesinin ana sayfası açılmalı ve önemli bölümlere bağlantılar üzerinden ulaşılıp ulaşılamadığı incelenmelidir.
Ana menüde bulunan bağlantılar tek tek kontrol edilebilir.
Hakkımızda, hizmetler, ürünler ve iletişim sayfalarının doğru adreslere yönlenip yönlenmediği değerlendirilmelidir.
Ardından sayfa içerisindeki bağlantılar kontrol edilmelidir.
Örneğin bir hizmet sayfasında başka bir hizmete yönlendiren bağlantı bulunuyorsa bu bağlantının çalıştığından emin olunmalıdır.
Ancak manuel olarak bir bağlantıya tıklanabilmesi, bütün arama motoru botlarının o bağlantıyı aynı şekilde işleyebileceğini garanti etmez.
Özellikle JavaScript ile oluşturulan karmaşık gezinme yapılarında taranabilirlik ayrıca incelenmelidir.
Kırık Bağlantılar SEO'yu Nasıl Etkiler?
Kırık bağlantı, kullanıcıyı veya tarayıcı botunu beklenen içeriğe ulaştıramayan bağlantıdır.
Örneğin bir web sayfasından kaldırılmış başka bir sayfaya bağlantı veriliyorsa ziyaretçi 404 hata sayfasıyla karşılaşabilir.
Bu durum, kullanıcı deneyimini olumsuz etkileyebilir.
Ayrıca kırık bağlantılar, botların site içerisinde ilgili sayfalara ulaşmasını zorlaştırabilir ve tarama kaynaklarının verimsiz kullanılmasına neden olabilir.
Ancak bütün 404 hatalarının SEO açısından mutlaka sorun olduğu düşünülmemelidir. Gerçekten kaldırılmış ve yerine uygun başka içerik bulunmayan bir sayfanın 404 yanıtı vermesi normal olabilir.
Önemli olan, kullanıcıları veya arama motorlarını yanlış adreslere yönlendiren bağlantıların tespit edilmesidir.
Kırık bağlantılar manuel olarak kontrol edilebileceği gibi bu amaçla hazırlanmış web sitesi tarama araçlarıyla da incelenebilir.
Kırık Bağlantılar Nasıl Düzeltilir?
Kırık bağlantı tespit edildiğinde öncelikle sorunun nedeni belirlenmelidir.
Bağlantı adresi yanlış yazılmış olabilir.
Hedef sayfa farklı bir URL'ye taşınmış olabilir.
Sayfa tamamen kaldırılmış olabilir.
Yanlış yazılmış bir bağlantı doğru URL ile değiştirilebilir.
İçerik kalıcı olarak yeni bir adrese taşınmışsa uygun durumlarda 301 yönlendirmesi kullanılabilir.
Sayfa kaldırılmış ve yerine ilgili başka bir içerik bulunmuyorsa bağlantı kaldırılabilir veya gerçekten uygun bir alternatif sayfaya yönlendirilebilir.
Her 404 sayfasının ana sayfaya yönlendirilmesi doğru bir çözüm değildir. Yönlendirmelerin kullanıcının beklentisiyle uyumlu olması gerekir.
Google Search Console ile Web Sitesi Tarama Kontrolü
Google Search Console, web sitesi sahiplerinin sitelerinin Google arama sistemlerindeki durumunu incelemesine yardımcı olan ücretsiz bir araçtır.
SEO çalışmalarında kullanılabilecek önemli bilgiler sunar.
Web sitesinin dizine eklenme durumları, belirli URL'lere ilişkin bilgiler ve çeşitli teknik sorunlar Search Console üzerinden değerlendirilebilir.
Özellikle büyük web sitelerinde yalnızca manuel kontroller yapmak yeterli olmayabilir.
Yüzlerce veya binlerce sayfası bulunan bir e-ticaret sitesinde her bağlantının tek tek incelenmesi oldukça zaman alabilir.
Bu gibi durumlarda Search Console ve uygun web sitesi tarama araçlarından birlikte yararlanmak daha etkili olabilir.
Google Search Console'da Hangi Alanlar Kontrol Edilmeli?
İlk olarak sayfa indeksleme raporları incelenebilir.
Bu raporlar üzerinden Google'ın hangi sayfaları dizine eklediği ve hangi sayfalarda farklı durumlar tespit ettiği değerlendirilebilir.
Ardından önemli URL'ler için URL Denetimi aracı kullanılabilir.
Bu araç, belirli bir sayfanın Google tarafından bilinip bilinmediği ve ilgili tarama ile indeksleme durumları hakkında bilgi sağlayabilir.
Ancak Search Console'un sunduğu bilgiler Google'a ilişkindir.
Bu nedenle bir sayfanın Search Console üzerinde dizine eklenmiş görünmesi, bütün yapay zeka sistemleri tarafından erişilebilir veya kullanılabilir olduğunu kanıtlamaz.
XML Site Haritası Tarama Sürecine Nasıl Yardımcı Olur?
XML site haritası, web sitesinde bulunan önemli URL'lerin arama motorlarına bildirilmesine yardımcı olan bir dosyadır.
Özellikle çok sayıda sayfası bulunan web sitelerinde yararlı olabilir.
Bir e-ticaret sitesinde ürün ve kategori sayfaları, bir blogda ise makaleler site haritası aracılığıyla daha düzenli biçimde sunulabilir.
Ancak XML site haritasına bir URL eklenmesi, o sayfanın mutlaka taranacağı veya Google dizinine alınacağı anlamına gelmez.
Site haritası, sayfaların keşfedilmesini destekleyen araçlardan biridir.
Bu nedenle site haritası oluşturmak kadar önemli URL'lerin doğru çalıştığından, ilgili sayfalara site içerisinden ulaşılabildiğinden ve teknik erişim engelleri bulunmadığından emin olmak da önemlidir.
robots.txt Nedir? Ne İşe Yarar?
robots.txt, bir web sitesindeki belirli URL yollarının otomatik tarayıcı botlar tarafından taranmasına ilişkin kuralları bildirmek için kullanılan metin dosyasıdır.
Bu dosya genellikle web sitesinin kök adresinde bulunur.
Örneğin www.orneksite.com alan adına sahip bir web sitesinin robots.txt dosyası normalde www.orneksite.com/robots.txt adresinden görüntülenebilir.
robots.txt, destekleyen botlara hangi URL yollarının taranmasının istenmediğini veya hangi alanlara erişimin uygun olduğunu bildirebilir.
Ancak bu dosyayla ilgili en önemli ayrımlardan biri şudur:
robots.txt, doğrudan bir sayfanın Google dizininden kaldırılmasını sağlayan bir güvenlik veya indeksleme aracı değildir.
Temel işlevi, kurallara uyan botların tarama davranışını yönlendirmektir.
Bir URL'nin taranmasının engellenmesi ile arama sonuçlarında gösterilmesinin engellenmesi aynı işlem değildir.
robots.txt Dosyası Olmazsa Ne Olur?
Her web sitesinde robots.txt dosyası bulunmak zorunda değildir.
Bu dosyanın bulunmaması, tek başına teknik SEO hatası sayılmaz.
robots.txt bulunmayan bir web sitesinde tarayıcı botları, bu dosyadan kaynaklanan ek tarama kısıtlamalarıyla karşılaşmaz.
Ancak bu durum bütün URL'lerin mutlaka taranacağı anlamına gelmez.
Sunucu yanıtları, erişim izinleri, bağlantı yapısı ve başka teknik koşullar tarama sürecini etkileyebilir.
Bazı içerik yönetim sistemleri robots.txt dosyasını otomatik olarak oluşturabilir veya ilgili adreste sanal olarak sunabilir.
Dolayısıyla site sahibi dosyayı doğrudan hazırlamamış olsa bile web sitesinde robots.txt bulunabilir.
Önemli olan, mevcut kuralların ne anlama geldiğinin anlaşılmasıdır.
robots.txt Dosyasında Yapılan Yaygın SEO Hataları
robots.txt dosyasında yapılan yanlış düzenlemeler, önemli sayfaların taranmasını engelleyebilir.
Bu sorunlar özellikle eski web sitelerinde, çok sayıda teknik değişiklik yapılmış projelerde veya farklı ekipler tarafından yönetilen kurumsal web sitelerinde görülebilir.
Örneğin web sitesi geliştirme aşamasında bazı dizinlerin taranması engellenmiş olabilir.
Site yayımlandıktan sonra bu kısıtlamalar kaldırılmamışsa önemli sayfalara erişim sorunları yaşanabilir.
Benzer şekilde geçmişte kullanılan bir uygulamaya ait kurallar, yeni web sitesi yapısına uygun olmayabilir.
Bu nedenle robots.txt dosyasının yalnızca mevcut olması değil, içeriğinin doğru hazırlanması da önemlidir.
Yanlışlıkla Bütün Web Sitesinin Taranmasını Engellemek
En ciddi hatalardan biri, web sitesinin tamamı için tarama kısıtlaması oluşturmaktır.
robots.txt içerisinde tüm kurallara uyan botları hedefleyen bir User-agent: * satırının ardından Disallow: / ifadesinin kullanılması, ilgili botlara web sitesinin kökünden başlayan bütün URL yollarını taramamaları gerektiğini bildirir.
Bu tür bir kural, yanlışlıkla canlı web sitesine taşınırsa ciddi tarama sorunlarına yol açabilir.
Özellikle geliştirme ve test ortamlarında kullanılan kuralların canlı ortama aktarılması sırasında dikkatli olunmalıdır.
Web sitesi yayımlandıktan sonra robots.txt dosyasının yeniden kontrol edilmesi yararlı bir uygulamadır.
Hakkımızda Sayfasını Yanlışlıkla Engellemek
Hakkımızda sayfası, işletmenin kimliğini ve uzmanlık alanlarını açıklayan önemli bölümlerden biridir.
Bu sayfanın robots.txt ile engellenmesi, kurallara uyan botların sayfadaki güncel bilgileri taramasını önleyebilir.
Örneğin işletmenin sunduğu hizmetler, faaliyet alanı veya uzmanlık bilgileri yalnızca Hakkımızda sayfasında ayrıntılı biçimde anlatılıyorsa bu sayfanın erişilebilirliği önemlidir.
Benzer şekilde iletişim sayfasının veya temel hizmet sayfalarının yanlışlıkla engellenmesi de sorun oluşturabilir.
Bu nedenle robots.txt kontrol edilirken yalnızca ana sayfa değil, işletmenin önemli bilgilerini içeren URL yolları da incelenmelidir.
Eski robots.txt Kurallarını Kontrol Etmemek
Web siteleri zaman içerisinde değişebilir.
Yeni sayfalar eklenebilir, eski içerikler kaldırılabilir, URL yapısı yenilenebilir ve farklı yazılım altyapılarına geçilebilir.
Ancak robots.txt dosyası bu değişikliklere uygun biçimde güncellenmeyebilir.
Örneğin geçmişte yalnızca teknik dosyaların bulunduğu bir dizin, daha sonra kullanıcıların erişmesi gereken içerikler için kullanılmaya başlanmış olabilir.
Eski robots.txt kuralları aynı şekilde bırakılırsa yeni içeriklerin taranması engellenebilir.
Bu nedenle özellikle büyük web sitesi güncellemelerinden sonra robots.txt dosyasının gözden geçirilmesi gerekir.
robots.txt ile noindex Arasındaki Fark Nedir?
robots.txt ile noindex birbirine karıştırılan iki farklı mekanizmadır.
robots.txt, botların belirli URL yollarını tarama davranışını yönlendirmek için kullanılır.
noindex ise destekleyen arama motorlarına belirli bir sayfanın dizine eklenmemesi gerektiğini bildiren bir yönergedir.
Örneğin bir sayfanın Google arama dizininde yer almaması isteniyorsa uygun şekilde kullanılan noindex yönergesi değerlendirilebilir.
Ancak burada önemli bir teknik ayrıntı bulunur.
Arama motorunun sayfadaki noindex yönergesini görebilmesi için genellikle sayfayı tarayabilmesi gerekir.
Sayfa robots.txt ile engellenmişse botun sayfa içindeki noindex yönergesini okuyamaması mümkündür.
Ayrıca robots.txt ile engellenen bir URL, başka bağlantılar aracılığıyla keşfedildiğinde bazı koşullarda içerik açıklaması olmadan arama sonuçlarında görünebilir.
Dolayısıyla robots.txt tek başına kesin bir indeksleme engeli olarak kullanılmamalıdır.
robots.txt Gizli Bilgileri Korur mu?
Hayır. robots.txt bir güvenlik sistemi değildir.
Bir URL'nin robots.txt içerisinde engellenmiş olması, o URL'nin internet kullanıcıları tarafından açılamayacağı anlamına gelmez.
Ayrıca bütün otomatik yazılımlar robots.txt kurallarına uymak zorunda değildir.
Bu nedenle kişisel bilgiler, özel belgeler, yönetim panelleri veya müşteri verileri gibi hassas içerikler yalnızca robots.txt ile korunmamalıdır.
Gizli kalması gereken içerikler için uygun kimlik doğrulama, erişim kontrolü ve sunucu güvenliği yöntemleri kullanılmalıdır.
robots.txt dosyasının amacı gizlilik sağlamak değil, tarama davranışını yönlendirmektir.
Yapay Zeka Botları İçin robots.txt Nasıl Değerlendirilmelidir?
Yapay zeka sistemleriyle ilişkili web tarayıcılarının tamamı aynı kuralları veya aynı kullanım amaçlarını paylaşmaz.
Bazı botlar arama ve bilgi getirme süreçlerinde kullanılabilirken bazıları farklı veri toplama amaçlarına hizmet edebilir.
Bu nedenle yapay zeka botlarına ilişkin erişim kararları verilirken botun ne amaçla çalıştığı ve hangi kuralları desteklediği incelenmelidir.
Örneğin bir işletme, içeriklerinin canlı arama sistemlerinde bulunabilmesini isteyebilir ancak belirli veri toplama faaliyetleri konusunda farklı tercihlere sahip olabilir.
Bu iki konu aynı şey değildir.
robots.txt üzerinde yapılan genel bir engelleme, site sahibinin hedeflemediği erişim kısıtlamalarına neden olabilir.
Dolayısıyla yapay zeka görünürlüğü hedefleyen işletmelerin robots.txt değişikliklerini plansız biçimde gerçekleştirmemesi gerekir.
Botların tarama erişimi, arama dizininde görünürlük ve yapay zeka modeli eğitiminde veri kullanımı birbirinden ayrı değerlendirilmelidir.
Google E-E-A-T Nedir?
Google E-E-A-T, içeriklerin kalitesini ve güvenilirliğini değerlendirmek için kullanılan önemli bir kavramsal çerçevedir.
E-E-A-T dört İngilizce kelimenin baş harflerinden oluşur:
-
Experience: Deneyim
-
Expertise: Uzmanlık
-
Authoritativeness: Otorite ve yetkinlik
-
Trustworthiness: Güvenilirlik
Bu yaklaşım, içeriklerin kim tarafından hazırlandığı, hangi deneyimlere dayandığı, konuya ilişkin uzmanlık düzeyi ve sunduğu bilgilerin ne kadar güvenilir olduğu gibi soruların değerlendirilmesine yardımcı olur.
E-E-A-T özellikle Google'ın arama kalitesini ele alan değerlendirme yaklaşımıyla ilişkilidir.
Ancak E-E-A-T, bir web sitesine tek bir sayısal puan veren veya doğrudan kullanılan bağımsız bir sıralama faktörü olarak düşünülmemelidir.
Google'ın kalite değerlendirme yaklaşımında kullanılan bu kavramlar, içerik kalitesini anlamak için yararlı bir çerçeve sunar.
Aynı şekilde bütün yapay zeka sistemlerinin Google'ın E-E-A-T yaklaşımını birebir kullandığını varsaymak doğru değildir.
Bununla birlikte deneyim, uzmanlık ve güvenilirlik gibi özellikler, kullanıcılar için değerli içerikler hazırlamanın önemli parçalarıdır.
E-E-A-T İçerisinde Deneyim Neden Önemlidir?
Deneyim, içerikte anlatılan konu hakkında gerçek uygulama veya kullanım bilgisine sahip olunmasıyla ilişkilidir.
Örneğin bir kişi satın aldığı bir çalışma masasının montaj sürecini, kullanım özelliklerini ve karşılaştığı sorunları anlatabilir.
Bu açıklamalar, ürünü gerçekten kullanmış olmanın sağladığı deneyimlere dayanabilir.
Benzer şekilde bir web tasarım uzmanı, gerçekleştirdiği projelerde karşılaştığı teknik sorunları ve uyguladığı çözümleri açıklayabilir.
Bu tür deneyimler, içeriklere genel tanımların ötesinde bilgiler kazandırır.
Ancak deneyim sahibi olmak, her konuda teknik uzmanlığa sahip olmakla aynı şey değildir.
Bir ürünü uzun süre kullanmış olmak kullanım deneyimi sunabilirken ürünün teknik güvenliği veya mühendislik özellikleri hakkında kesin değerlendirmeler yapmak farklı uzmanlık gerektirebilir.
Bu nedenle deneyime dayalı açıklamalar ile uzmanlık gerektiren teknik iddialar birbirinden ayrılmalıdır.
E-E-A-T İçerisinde Uzmanlık Nasıl Gösterilir?
Uzmanlık, belirli bir konuya ilişkin bilgi ve yetkinliği ifade eder.
Bir kişinin eğitim geçmişi, mesleki deneyimleri, teknik bilgisi ve gerçekleştirdiği çalışmalar uzmanlığını destekleyebilir.
Ancak her konuda aynı tür uzmanlık kanıtı aranmaz.
Örneğin sağlıkla ilgili önemli bir konuda hazırlanan içerikte ilgili mesleki yeterlilikler ve doğru bilgiler büyük önem taşır.
Buna karşılık bir ahşap mobilyanın günlük kullanımına ilişkin değerlendirmede gerçek kullanıcı deneyimleri yararlı olabilir.
Web sitesi sahipleri açısından önemli olan, içeriklerin hangi bilgi birikimine dayandığının anlaşılır olmasıdır.
Bir işletme sunduğu hizmetlerle ilgili açıklayıcı rehberler hazırlayabilir.
Gerçek çalışma örneklerini paylaşabilir.
Projelerinde kullandığı yöntemleri, uygun durumlarda teknik ayrıntılarla açıklayabilir.
Ancak yalnızca "uzman ekip" veya "sektörün en iyisi" gibi ifadeler kullanılması, tek başına uzmanlığı kanıtlamaz.
E-E-A-T İçerisinde Otorite Nasıl Oluşur?
Otorite veya yetkinlik, bir kişi ya da markanın belirli bir konuda başkaları tarafından ne ölçüde tanındığı ve güvenilir bir bilgi kaynağı olarak değerlendirildiğiyle ilişkilidir.
Bir işletme kendi web sitesinde uzmanlık alanlarını açıklayabilir.
Ancak işletmenin kendisi hakkında olumlu ifadeler kullanması, dış dünyadaki itibarının tamamını göstermez.
Bu nedenle marka hakkında başka kişi ve kuruluşlar tarafından yayımlanan bilgiler de önemlidir.
Örneğin bir üreticinin sektörel bir yayında ele alınması, uzmanlık alanıyla ilgili bir etkinlikte yer alması veya gerçek müşterileri tarafından değerlendirilmesi markanın bilinirliğini destekleyebilir.
Bununla birlikte her marka bahsinin aynı değerde olduğu düşünülmemelidir.
Konuyla ilgisiz, güvenilirliği düşük veya yalnızca bağlantı oluşturmak amacıyla hazırlanmış içerikler, marka otoritesini güçlendiren gerçek işaretlerle aynı şekilde değerlendirilmemelidir.
Dijital otorite, mümkün olduğunca gerçek faaliyetler, güvenilir bilgiler ve doğal biçimde oluşan tanınırlık üzerine kurulmalıdır.
E-E-A-T İçerisinde Güvenilirlik Neden Belirleyicidir?
Güvenilirlik, bir içeriğin veya web sitesinin doğru, dürüst ve güven veren bilgiler sunmasıyla ilişkilidir.
Bir işletmenin ürün özelliklerini doğru belirtmesi, hizmet kapsamını açıkça anlatması ve yanıltıcı ifadeler kullanmaması güvenilirlik açısından önemlidir.
Örneğin bir e-ticaret sitesinde ürünün malzemesi, ölçüleri ve kullanım özellikleri gerçeği yansıtmalıdır.
Bir hizmet sağlayıcı, sunmadığı özellikleri hizmet paketine dahilmiş gibi göstermemelidir.
İletişim bilgileri güncel olmalı ve müşterilerin ihtiyaç duyduğu temel açıklamalara ulaşması kolaylaştırılmalıdır.
Güvenilirlik yalnızca metinlerin yazım biçimiyle ilgili değildir.
İşletmenin gerçek çalışma yöntemi, müşteri ilişkileri, şeffaflığı ve sunduğu bilgilerin doğruluğuyla da ilişkilidir.
Bu nedenle güvenilir bir dijital kimlik oluşturmak, yalnızca SEO düzenlemesi yapmaktan daha kapsamlı bir süreçtir.
E-E-A-T ve Yapay Zeka SEO Arasındaki İlişki
Yapay zeka destekli arama sistemleri, kullanıcıların sorularına cevap oluştururken farklı bilgi kaynaklarından yararlanabilir.
Bu sistemlerin kullandığı kaynaklar ve değerlendirme yöntemleri platformlara göre değişir.
Ancak internette doğru, kapsamlı ve tutarlı bilgiler sunan bir marka oluşturmak hem geleneksel SEO hem de yapay zeka odaklı görünürlük açısından yararlı olabilir.
Örneğin bir işletmenin faaliyet alanı yalnızca kendi web sitesinde kısa biçimde belirtiliyorsa dijital ortamda sınırlı bilgi bulunabilir.
Buna karşılık işletme hakkında gerçek projeler, güncel hizmet açıklamaları, sektörel çalışmalar ve bağımsız değerlendirmeler bulunması daha geniş bir bilgi ortamı oluşturabilir.
Bu durum markanın farklı internet kaynaklarında daha anlaşılır biçimde temsil edilmesini destekleyebilir.
Ancak E-E-A-T ile ilişkili iyileştirmelerin yapay zeka sistemlerinde belirli bir sıralama veya öneri sonucunu garanti ettiği düşünülmemelidir.
Site Dışı SEO ve Dijital Marka İtibarı
Bir işletmenin internet üzerindeki görünürlüğü yalnızca kendi web sitesiyle sınırlı değildir.
Başka web sitelerinde yayımlanan içerikler, gerçek kullanıcı değerlendirmeleri, sektörel haberler ve topluluk tartışmaları da markanın dijital varlığının parçalarıdır.
Site dışı SEO, web sitesinin dışındaki bu tür ilişkili unsurları değerlendiren geniş bir çalışma alanıdır.
Geleneksel SEO'da başka web sitelerinden gelen bağlantılar önemli konular arasında yer alır.
Ancak marka görünürlüğünü yalnızca bağlantı sayısına indirgemek doğru değildir.
Bir işletmenin adının internet üzerinde hangi bağlamlarda geçtiği, hangi konularla ilişkilendirildiği ve nasıl değerlendirildiği de marka itibarı açısından önemlidir.
Örneğin bir mobilya üreticisinin ahşap malzemeler konusunda sektörel bir yayında yer alması, işletmenin uzmanlık alanıyla ilişkili bir görünürlük oluşturabilir.
Buna karşılık konuyla ilgisiz yüzlerce web sitesinde aynı tanıtım metninin yayımlanması benzer bir değer sunmayabilir.
Marka Bahsi Nedir? SEO ve Yapay Zeka Görünürlüğünü Nasıl Etkiler?
Marka bahsi, bir işletmenin veya ürünün başka bir dijital içerikte adıyla anılmasıdır.
Bu bahislere bazen bağlantı eşlik edebilir, bazen ise yalnızca marka adı geçebilir.
Örneğin bir teknoloji blogunda belirli bir yazılım şirketinin ürününden söz edilmesi marka bahsi oluşturur.
Bir forumda gerçek bir müşterinin satın aldığı ürünle ilgili deneyimini paylaşması da aynı kapsamda değerlendirilebilir.
Marka bahisleri, işletmenin internet üzerindeki varlığını daha geniş bir alana taşıyabilir.
Ancak her marka bahsinin Google sıralamalarına veya yapay zeka cevaplarına doğrudan ve ölçülebilir katkı sağladığı söylenemez.
Asıl önemli olan, işletmenin faaliyet alanıyla ilişkili ve güvenilir bir dijital görünürlük oluşturmasıdır.
Marka Görünürlüğünü Artırmak İçin Neler Yapılabilir?
Bir işletme, gerçek çalışmalarının daha fazla kişi tarafından keşfedilmesini sağlayacak faaliyetlere odaklanabilir.
Örneğin yeni bir ürün geliştiren firma, ürünün teknik özelliklerini ve kullanım alanlarını açıklayan ayrıntılı bir tanıtım hazırlayabilir.
Sektörel yayınlarla iletişim kurabilir.
Uygun etkinliklere katılabilir.
Gerçek projelerini ve deneyimlerini paylaşabilir.
Uzmanlık alanıyla ilgili topluluk tartışmalarına katkıda bulunabilir.
Bu faaliyetlerin amacı yalnızca arama motorları için bağlantı oluşturmak olmamalıdır.
İşletmenin hedef kitlesine gerçekten yararlı bilgiler sunması, daha sürdürülebilir bir marka görünürlüğü stratejisi oluşturabilir.
Wikipedia Marka Otoritesi İçin Neden Önemlidir?
Wikipedia, kullanıcılar ve gönüllü editörler tarafından geliştirilen büyük bir çevrim içi ansiklopedi projesidir.
Çok sayıda kişi, kuruluş, kavram ve olay hakkında ansiklopedik bilgiler içerir.
Bu nedenle internet üzerindeki bilgi ekosisteminde önemli bir yere sahiptir.
Ancak Wikipedia'nın temel amacı işletmelerin tanıtımını yapmak değildir.
Bir işletme hakkında Wikipedia maddesi oluşturulabilmesi için ilgili konunun ansiklopedik açıdan kayda değer olması ve yeterli düzeyde güvenilir, bağımsız kaynaklarla ele alınmış olması gerekir.
Yalnızca bir şirketin kurulmuş olması veya kendi web sitesinde kapsamlı açıklamalar bulunması, Wikipedia maddesi açılması için yeterli olmayabilir.
Her İşletme Wikipedia Sayfası Açabilir mi?
Wikipedia üzerinde şirketler hakkında maddeler bulunabilir.
Ancak her işletmenin kendi adına bir madde oluşturma hakkı olduğu düşünülmemelidir.
Bir işletmenin yeterli bağımsız kaynakta anlamlı biçimde ele alınması, kayda değerlik değerlendirmesinde önemlidir.
Ayrıca işletme sahiplerinin veya çalışanlarının kendi markaları hakkında madde oluşturması çıkar çatışması sorunlarına yol açabilir.
Wikipedia'nın tarafsızlık ve çıkar çatışmasına ilişkin kuralları dikkate alınmalıdır.
Bu nedenle Wikipedia, yeni kurulan işletmeler için doğrudan tanıtım yapılacak bir reklam platformu olarak değerlendirilmemelidir.
Bir işletmenin Wikipedia'da yer almak amacıyla gerçek olmayan bilgiler oluşturması veya bağımsız görünüm altında tanıtım yaptırması uygun bir yaklaşım değildir.
Daha doğru yöntem, işletmenin kendi alanında gerçek çalışmalar gerçekleştirmesi ve bu çalışmaların uygun bağımsız yayınlarda doğal biçimde ele alınmasıdır.
Reddit Nedir? Marka Görünürlüğünde Nasıl Kullanılır?
Reddit, kullanıcıların belirli konular etrafında topluluklar oluşturabildiği ve tartışmalara katılabildiği bir platformdur.
Farklı ilgi alanlarına yönelik topluluklarda kullanıcılar sorular sorabilir, deneyimlerini paylaşabilir ve önerilerde bulunabilir.
Bu içerikler, insanların ürünler veya hizmetler hakkında gerçek kullanıcı deneyimlerini araştırmasına yardımcı olabilir.
Reddit'teki bazı tartışmalar arama motorları aracılığıyla da keşfedilebilir.
Bu nedenle Reddit, markaların faaliyet gösterdiği sektörlerle ilgili kullanıcı sorularını anlamak açısından değerlendirilebilecek platformlardan biridir.
Reddit Üzerinde İşletme Tanıtımı Nasıl Yapılmalı?
Reddit toplulukları genellikle belirli kurallar ve kullanıcı beklentileri etrafında şekillenir.
Bu nedenle her topluluğa aynı reklam metnini göndermek veya ilgisiz paylaşımlar yapmak doğru bir strateji değildir.
Bir işletme öncelikle faaliyet alanıyla ilişkili toplulukları inceleyebilir.
Kullanıcıların hangi sorunları yaşadığını, hangi konuları merak ettiğini ve hangi bilgileri yararlı bulduğunu değerlendirebilir.
Örneğin web tasarım hizmeti sunan bir işletme, web sitesi performansı veya mobil uyumluluk konusunda sorulan sorulara bilgi vererek katkıda bulunabilir.
Ancak bu katkının gerçek ve açıklayıcı olması gerekir.
İşletmeyle ilişkisi bulunan bir kişinin kendisini bağımsız müşteri gibi göstermesi veya sahte değerlendirmeler oluşturması güvenilir bir yöntem değildir.
İlgili topluluk kuralları izin veriyorsa işletmeyle olan bağın açıkça belirtilmesi daha doğru bir yaklaşımdır.
Reddit'te Marka Topluluğu Açmak Gerekli mi?
Bazı işletmeler kendi markaları için Reddit topluluğu oluşturmayı tercih edebilir.
Ancak bu yöntem her işletme için gerekli değildir.
Bir topluluğun yararlı olabilmesi için gerçek kullanıcıların ilgisini çekmesi ve sürdürülebilir tartışmalar oluşturabilmesi gerekir.
Örneğin çok sayıda aktif kullanıcısı bulunan bir yazılım ürününün kullanıcıları, sorunlarını ve önerilerini paylaşmak için bir toplulukta bir araya gelebilir.
Buna karşılık henüz aktif kullanıcı kitlesi bulunmayan bir işletme için yalnızca marka adına bir topluluk açılması önemli bir fayda sağlamayabilir.
Dolayısıyla Reddit topluluğu oluşturma kararı, markanın gerçek müşteri kitlesine ve iletişim ihtiyaçlarına göre verilmelidir.
Quora Nedir? SEO ve Marka Bilinirliğine Nasıl Katkı Sağlar?
Quora, kullanıcıların farklı konularda sorular sorabildiği ve bu sorulara cevap verebildiği bir bilgi paylaşım platformudur.
Platformda teknoloji, işletme yönetimi, dijital pazarlama, eğitim ve çok sayıda başka konuda tartışmalar bulunabilir.
Quora'nın marka görünürlüğü açısından değerlendirilebilecek yönlerinden biri, kullanıcıların doğrudan bilgi ihtiyacını yansıtan sorular oluşturmasıdır.
Örneğin bir kullanıcı profesyonel web sitesi hazırlatırken nelere dikkat etmesi gerektiğini sorabilir.
Başka bir kullanıcı küçük işletmeler için e-ticaret sistemlerini karşılaştırmak isteyebilir.
Bu sorular, işletmelerin hedef kitlelerinin gerçek bilgi ihtiyaçlarını anlamasına yardımcı olabilir.
Quora Üzerinde Faydalı Cevaplar Nasıl Hazırlanır?
Quora'da etkili bir bilgi paylaşımı için öncelikle sorunun doğrudan cevaplanması gerekir.
Örneğin bir kullanıcı "Küçük işletmeler için hangi web sitesi altyapısı daha uygundur?" sorusunu yöneltiyorsa cevap yalnızca belirli bir markanın tanıtımından oluşmamalıdır.
Kullanıcının teknik ihtiyaçları, ürün sayısı, bütçesi ve site yönetimi beklentileri gibi unsurlar açıklanabilir.
Farklı sistemlerin avantajları ve sınırlamaları dürüst biçimde değerlendirilebilir.
İşletme kendisiyle ilgili bir konuyu açıklıyorsa bu bağlantıyı saklamamalıdır.
Birden fazla hesap kullanarak sahte sorular oluşturmak, kendi markasını bağımsız kullanıcı gibi övmek veya gerçek olmayan tavsiyeler yayımlamak güvenilir bir marka stratejisi değildir.
Doğru yaklaşım, uzmanlık alanıyla ilgili sorulara açık ve gerçekten faydalı yanıtlar sunmaktır.
Kullanıcı Tarafından Oluşturulan İçerikler Neden Önemlidir?
Kullanıcı tarafından oluşturulan içerikler, İngilizcede User Generated Content veya kısaca UGC olarak adlandırılır.
Bu kavram; kullanıcı yorumlarını, topluluk paylaşımlarını, forum tartışmalarını ve çeşitli değerlendirmeleri kapsayabilir.
Bir markanın kendi web sitesinde yayımladığı açıklamalarla gerçek müşterilerin deneyimleri aynı tür bilgi değildir.
İşletme kendi ürününü tanıtırken doğal olarak olumlu özelliklerini vurgulayabilir.
Buna karşılık gerçek kullanıcı yorumlarında ürünün avantajları, sınırlamaları ve kullanım deneyimleri birlikte ele alınabilir.
Bu bilgiler potansiyel müşteriler için değerli olabilir.
Ancak kullanıcı tarafından oluşturulan bütün içeriklerin doğru veya tarafsız olduğu varsayılmamalıdır.
Forumlarda yanlış bilgiler, yanıltıcı değerlendirmeler ve reklam amacı taşıyan paylaşımlar da bulunabilir.
Bu nedenle kullanıcı yorumlarının niteliği, bağlamı ve gerçekliği önemlidir.
Sahte Yorumlar ve Satın Alınan Tanıtımlar SEO'yu Nasıl Etkiler?
Bazı işletmeler daha hızlı görünürlük elde etmek amacıyla ücretli yorumlar, hazır tanıtım yazıları veya toplu bağlantı hizmetlerinden yararlanmayı düşünebilir.
Ancak bu tür çalışmalar dikkatli değerlendirilmelidir.
Bir yayıncıya içerik üretimi için ödeme yapılması ile bağımsız bir kullanıcı değerlendirmesi görünümü altında reklam yayımlanması aynı şey değildir.
Ücretli iş birlikleri uygun biçimde açıklanmalı ve ilgili platformların kurallarına uyulmalıdır.
Gerçek olmayan müşteri yorumları oluşturmak, sahte kullanıcı hesaplarıyla marka hakkında olumlu tartışmalar başlatmak veya arama motorlarını yanıltmak amacıyla bağlantı satın almak sürdürülebilir bir yaklaşım değildir.
Bu tür uygulamalar platform kurallarını ihlal edebilir ve marka güvenilirliğini zedeleyebilir.
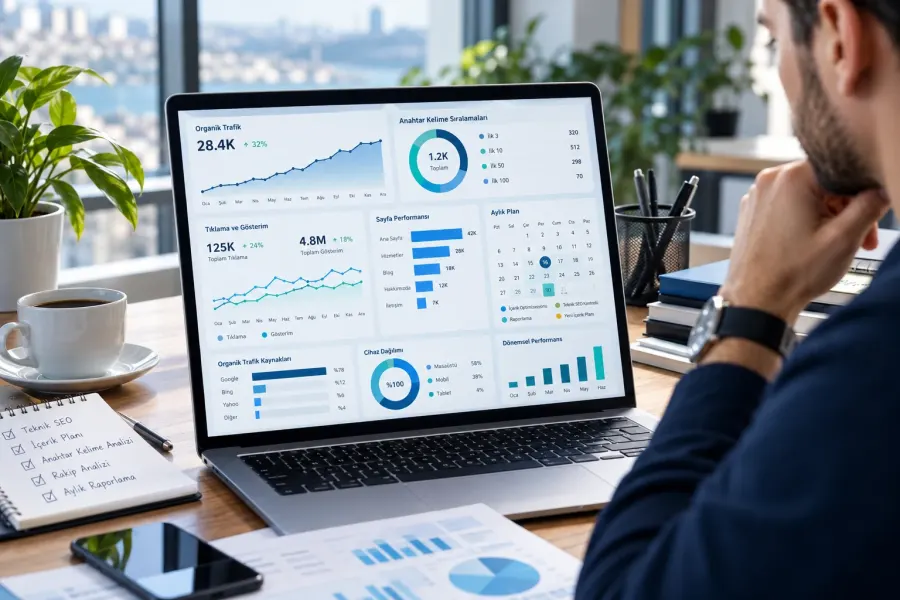
Ayrıca bir web sitesinin yalnızca organik trafik tahminine bakarak güvenilir olduğu sonucuna varılamaz.
Potansiyel bir yayın veya iş birliği değerlendirilirken sitenin konusu, içerik kalitesi, gerçek hedef kitlesi, reklam politikaları ve itibarı birlikte incelenmelidir.
İşletmelerin kısa vadeli görünürlük yerine gerçek kullanıcıların ve güvenilir yayınların ilgisini çekebilecek çalışmalar geliştirmesi daha sağlıklı bir stratejidir.
Marka İtibarını Güçlendirmek İçin Hangi Platformlar Kullanılabilir?
Bir işletmenin dijital itibarı yalnızca tek bir platforma bağlı olmamalıdır.
Faaliyet alanına göre sektörel yayınlar, profesyonel topluluklar, gerçek müşteri değerlendirmeleri ve uygun sosyal medya platformları değerlendirilebilir.
Örneğin kurumsal hizmet sunan bir işletme için profesyonel ağlarda faaliyet göstermek yararlı olabilir.
Tüketici ürünleri satan bir işletme için ürün kullanım deneyimleri ve müşteri geri bildirimleri önem taşıyabilir.
Teknik ürün geliştiren bir işletme, uzmanlık alanıyla ilgili topluluklarda açıklayıcı bilgiler paylaşabilir.
Ancak bütün platformlarda bulunmaya çalışmak zorunlu değildir.
Önemli olan, hedef müşteri kitlesinin gerçekten kullandığı ve işletmenin değer sunabileceği alanlara odaklanmaktır.
Bu yaklaşım marka çalışmalarının daha planlı yürütülmesini sağlar.
SEO İçin Marka Hakkında Çelişkili Bilgiler Nasıl Düzeltilir?
Bir işletmenin internet üzerinde farklı dönemlerde yayımlanmış çok sayıda içeriği bulunabilir.
Zaman içerisinde hizmetler değişebilir, işletme yeni alanlarda faaliyet göstermeye başlayabilir veya bazı ürünlerini satıştan kaldırabilir.
Ancak eski içerikler güncellenmediğinde marka hakkında çelişkili bilgiler oluşabilir.
Örneğin işletmenin ana sayfasında yalnızca web tasarımı hizmeti verdiği belirtilirken eski bir tanıtım yazısında farklı hizmetler sunduğu yazabilir.
Benzer şekilde eski iletişim bilgileri veya geçmişte kullanılan marka açıklamaları internet üzerinde bulunmaya devam edebilir.
Bu durumda ilk olarak işletmenin kontrol ettiği web sayfaları güncellenmelidir.
Ardından işletmenin doğrudan yönetebildiği profil ve tanıtım alanları incelenebilir.
Bağımsız yayınlarda önemli yanlış bilgiler bulunuyorsa ilgili yayıncıya düzeltme talebi iletilebilir.
Ancak işletmenin başka web sitelerindeki bütün bilgileri doğrudan değiştirebilmesi mümkün değildir.
Bu nedenle doğru ve tutarlı bilgilerin işletmenin kendi dijital kanallarında açık biçimde bulunması önemlidir.
Örnek Uygulama: Bir Web Tasarım Şirketinin SEO ve Marka Görünürlüğü Kontrolü
Bir web tasarım şirketinin Google ve yapay zeka destekli arama sistemlerinde daha anlaşılır biçimde temsil edilmek istediğini düşünelim.
İşletme kurumsal web sitesi tasarımı, e-ticaret sitesi geliştirme ve SEO hizmetleri sunuyor olsun.
Bu işletme için ilk adım mevcut web sitesinin teknik durumunu kontrol etmektir.
Birinci Aşama: Önemli Sayfaları Belirlemek
Öncelikle işletmenin ana sayfası, Hakkımızda sayfası, hizmet sayfaları ve iletişim bölümü belirlenir.
Bu sayfalarda doğru ve güncel bilgilerin bulunup bulunmadığı incelenir.
Hizmet açıklamalarının yeterince ayrıntılı olup olmadığı değerlendirilir.
Örneğin e-ticaret sitesi tasarımı hizmetinin yalnızca tek bir cümleyle anlatılması yerine, hizmetin kapsamı ve hangi işletmeler için uygun olduğu açıklanabilir.
İkinci Aşama: Tarama Sorunlarını Kontrol Etmek
Ana menüdeki bağlantılar test edilir.
Önemli hizmet sayfalarına site içerisinden ulaşılabildiği kontrol edilir.
Kırık bağlantılar belirlenir.
robots.txt dosyasında önemli sayfaların yanlışlıkla engellenip engellenmediği incelenir.
Google Search Console üzerinden ilgili URL'lerin durumları değerlendirilir.
Üçüncü Aşama: E-E-A-T Açısından İncelemek
İşletmenin gerçek uzmanlık alanları belirlenir.
Hakkımızda sayfasında bu bilgiler anlaşılır biçimde açıklanır.
Gerçek projeler ve uygun referanslar varsa ilgili sayfalarda sunulur.
Teknik makalelerde kullanılan bilgilerin doğruluğu kontrol edilir.
Gerçek çalışma deneyimlerine dayalı açıklamalar uygun içeriklere eklenebilir.
Dördüncü Aşama: Site Dışı Görünürlüğü Değerlendirmek
İşletme adı arama motorlarında araştırılır.
Mevcut marka bahisleri incelenir.
Eski veya yanlış bilgiler tespit edilir.
İşletmenin faaliyet alanıyla ilişkili topluluklar ve sektörel yayınlar değerlendirilir.
Gerçek kullanıcı sorularına faydalı cevaplar sunulabilecek alanlar belirlenir.
Bu çalışmaların amacı yalnızca daha fazla bağlantı elde etmek değil, işletmenin faaliyet alanıyla ilişkili güvenilir bir dijital kimlik geliştirmektir.
Web Sitesi Taranabilirliği ve Marka Güvenilirliği Kontrol Listesi
SEO ve yapay zeka görünürlüğü çalışmalarını birlikte değerlendirmek isteyen işletmeler aşağıdaki kontrol listesinden yararlanabilir.
| Kontrol alanı | İncelenecek konu |
|---|---|
| Ana sayfa | Temel hizmetlere ve önemli bilgilere bağlantı bulunması |
| Hakkımızda | Güncel marka, faaliyet ve uzmanlık bilgilerinin sunulması |
| Hizmet sayfaları | İçeriklerin ayrıntılı, doğru ve erişilebilir olması |
| Site içi bağlantılar | Kırık veya yanlış yönlendiren bağlantıların kontrolü |
| robots.txt | Önemli URL yollarının yanlışlıkla engellenmemesi |
| İndeksleme | Google Search Console üzerinden önemli sayfaların incelenmesi |
| İçerik kalitesi | Doğru bilgiler, gerçek deneyimler ve açıklayıcı anlatımlar |
| Marka bilgileri | Web sitesi genelinde tutarlı tanıtım ve iletişim bilgileri |
| Site dışı görünürlük | Gerçek ve konuyla ilişkili marka bahisleri |
| Kullanıcı toplulukları | Şeffaf, faydalı ve platform kurallarına uygun katılım |
| Güvenilirlik | Sahte yorum, yanıltıcı iddia ve yapay tanıtımlardan kaçınma |
Bu kontroller, web sitesinin mevcut durumuna göre belirli aralıklarla tekrarlanabilir.
Özellikle büyük teknik güncellemelerden, alan adı değişikliklerinden veya site taşıma işlemlerinden sonra taranabilirlik kontrollerinin yeniden yapılması yararlıdır.
Crawling ve E-E-A-T Çalışmaları Ne Kadar Sürede Etki Gösterir?
Web sitesi taranabilirliğiyle ilgili teknik bir sorunun düzeltilmesi, arama motoru botlarının ilgili sayfalara ulaşmasını kolaylaştırabilir.
Ancak sorunun giderilmesinin ardından sayfaların ne zaman yeniden taranacağı veya dizine ekleneceği kesin olarak belirlenemez.
Benzer şekilde marka güvenilirliği ve uzmanlık çalışmalarının da bütün web siteleri için geçerli tek bir sonuç süresi bulunmaz.
Bir işletmenin gerçek deneyimlerini dijital ortamda daha iyi açıklaması, içerik kalitesini artırabilir.
Bağımsız yayınlarda yer alması veya gerçek kullanıcı değerlendirmeleri kazanması marka bilinirliğini destekleyebilir.
Ancak bu çalışmaların belirli bir tarihte arama sıralamasını yükselteceği veya yapay zeka sistemlerinde önerilme sağlayacağı garanti edilemez.
Bu nedenle crawling ve E-E-A-T ile ilişkili çalışmalar, tek seferlik işlemler yerine düzenli geliştirme ve değerlendirme süreçleri olarak görülmelidir.
Sonuç: Arama Motorları ve Yapay Zeka Sistemleri İçin Güçlü Bir Dijital Temel Oluşturmak
Bir web sitesinin Google veya yapay zeka destekli arama sistemlerinde görünür olması, yalnızca içerik hazırlamakla ilgili değildir.
İlgili sistemlerin web sayfalarına ulaşabilmesi, önemli bilgilerin doğru biçimde sunulması ve işletmenin internet üzerindeki kimliğinin anlaşılır olması da önemlidir.
Crawling, web sayfalarının otomatik sistemler tarafından keşfedilmesini ve incelenmesini sağlayan temel süreçlerden biridir.
robots.txt dosyası bu süreçte botların tarama davranışını yönlendirebilir. Ancak yanlış yapılandırılmış kurallar, önemli sayfaların taranmasını engelleyebilir.
Google E-E-A-T yaklaşımı ise içerik kalitesinin değerlendirilmesinde deneyim, uzmanlık, otorite ve güvenilirlik gibi unsurların önemini anlamaya yardımcı olur.
Bunların yanında işletmenin başka web sitelerinde nasıl temsil edildiği, gerçek kullanıcıların hangi deneyimleri paylaştığı ve marka hakkında hangi bilgilerin bulunduğu da dijital itibarın önemli parçalarıdır.
Wikipedia, Reddit ve Quora gibi platformlar bazı işletmelerin bilgi ve görünürlük ekosisteminde rol oynayabilir. Ancak bu platformlar yalnızca SEO amacıyla tanıtım yapılacak alanlar olarak değerlendirilmemelidir.
Gerçek deneyimlere dayanan, şeffaf ve kullanıcılara değer sağlayan katılım daha sağlıklı bir yaklaşım oluşturur.
Web sitesi sahipleri için öncelikli hedef; önemli sayfaların erişilebilirliğini sağlamak, tarama engellerini gidermek, doğru içerikler hazırlamak ve markanın gerçek uzmanlık alanlarını açık biçimde anlatmaktır.
Güçlü bir SEO stratejisi, yalnızca arama motorlarının web sitesini bulabilmesini değil, buldukları içeriklerin doğru, anlaşılır, faydalı ve güvenilir olmasını da hedeflemelidir.
Bu yaklaşım, hem geleneksel arama motorları hem de gelişen yapay zeka destekli bilgi sistemleri için daha sağlam bir dijital görünürlük temeli oluşturur.