Google necə işləyir? Bir axtarışın 1 saniyəlik səyahəti
Axtar düyməsinə basanda Google internetə baxmır, öz surətini axtarır. Ekranın Arxası seriyasının ilk bölümü: tarama, indeksə əlavə, sıralama və saytınızın Google-da olub-olmadığını yoxlamağın üç yolu.
Telefonunuza bir sual yazırsınız, Axtar düyməsini basırsınız və bir saniyə keçmədən cavab ekrandadır. Çoxumuz elə bilirik ki, Google həmin bir saniyədə bütün interneti sürətlə gəzib axtardığımızı tapır. Əslində Google o anda internetə ümumiyyətlə baxmır. Cavabı aylardır oxuyub saxladığı öz surətindən çıxarır.
Bu yazı YouTube kanalımızdakı Ekranın Arxası (Ekranın Arkası) seriyasının ilk bölümünün yazılı formasıdır. Seriyanın hər bölümündə hər gün istifadə etdiyimiz bir texnologiyanın arxasındakı əsl mexanizmə baxırıq. Videonu izləyə və ya yalnız yazını oxuya bilərsiniz. Yazıdakı təsvirlər videodakı səhnələrin özüdür. Video Türkiyə türkcəsindədir.
Qısaca:
- Axtarış etdiyiniz zaman Google interneti deyil, öz indeksini axtarır. İndeks internetdəki səhifələrin Google-dakı surətidir.
- Səhifənin axtarışda çıxması üçün üç mərhələdən keçməsi lazımdır: tarama, indeksə əlavə və nəticələrin göstərilməsi.
- İndeksdə olmayan səhifə yayımda olsa belə Google-da tapılmır. Bunun ən çox rast gəlinən səbəbi unudulmuş noindex sətri və ya heç bir yerdən keçid almayan səhifədir.
- Saytınızın indeksdə olub-olmadığını site: axtarışı və Search Console ilə özünüz yoxlaya bilərsiniz.
Axtarış etdiyiniz zaman Google interneti axtarmır
İnternetdə yüz milyardlarla səhifə var. Google hər axtarışda onları bir-bir açsaydı, cavab bir saniyəyə gəlməzdi. Ona görə Google işi əvvəlcədən görür: səhifələri oxuyur, təhlil edir və öz arxivinə yazır. Bu arxivin adı indeksdir.
Kitabın sonundakı göstəricini düşünün. "Fotosintez" sözünü tapmaq üçün kitabı başdan-başa oxumursunuz; arxadakı göstəriciyə baxırsınız: fotosintez, səhifə 112. Google-un etdiyi də budur. Yeganə fərq kitabın internetin özü olmasıdır.
Google-un öz izahına görə bu indeksdə yüz milyardlarla veb-səhifə var və həcmi 100 milyon giqabaytı çoxdan keçib. Bu cümlənin sayt sahibləri üçün çox vacib nəticəsi var: Google-un surətində olmayan səhifə Google üçün yoxdur. Səhifə yayımda ola bilər, gözəl ola bilər, pulu ödənmiş ola bilər. İndeksdə deyilsə, onu Google axtarışında tapmağın yolu yoxdur.
1996: LEGO qutusu, googol və bir qaraj
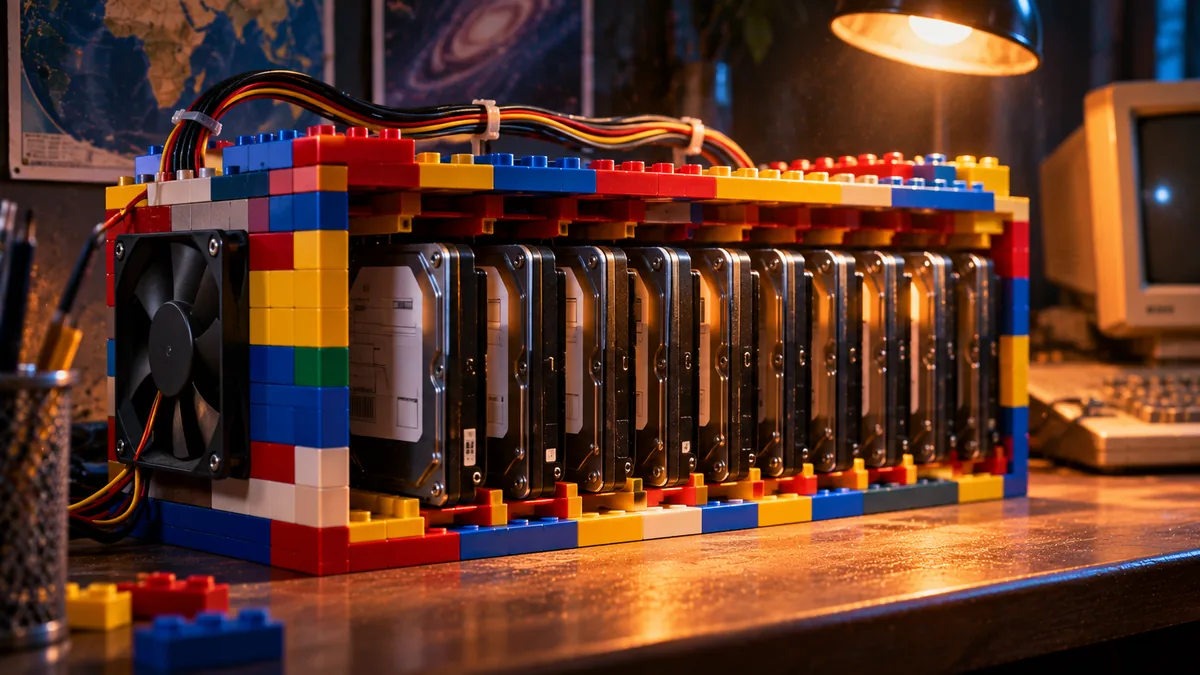
Hekayə 1996-cı ildə Kaliforniyadakı Stenford Universitetində başlayır. İki doktorant, Larri Peyc (Larry Page) və Sergey Brin, adı bir az qəribə olan elmi layihə üzərində işləyir: BackRub. Disklərini hazır korpus əvəzinə LEGO hissələrindən düzəltdikləri qutuya düzürlər. Bu gün milyardlarla insanın istifadə etdiyi axtarış sisteminin ilk forması rəngli oyuncaq hissələrinin içində işləyirdi.
Layihəyə yeni ad lazım olanda ağıllarında googol sözü var: 1-in arxasına yüz sıfır yazanda alınan ədədin adı. Stenfordun arxivindəki təsvirə görə domen adının boş olub-olmadığı yoxlanarkən söz səhvən "google" kimi yazılır, bu yazılış xoşlarına gəlir və belə qalır. google.com domeni 15 sentyabr 1997-ci ildə qeydiyyata alınır. 1998-ci ildə şirkət yaradılır və ilk ofis Menlo-Parkda kirayə götürülmüş evin qarajı olur.
O iki tələbənin həll etdiyi əsas problem bu gün də Google-un mərkəzində durur. Bunu anlamaq üçün Google-un hər gün gördüyü üç işə baxaq.
Google-un üç mərhələsi: tarama, indeksə əlavə, nəticələrin göstərilməsi
Google Search Central sənədlərində axtarış üç mərhələyə bölünür. Hər səhifə onlardan ardıcıl keçir; birində ilişib qalan səhifə axtarışda görünmür.
1. Tarama: Googlebot səhifələri necə tapır?
Google-un Googlebot adlı proqramı var. Onu internetdə gəzən bir oxucu kimi düşünün: səhifəni açır, oxuyur, səhifədəki keçidləri qeyd edir və növbətisinə keçir. Hörümçək bənzətməsi buradan gəlir; internetə də buna görə "veb", yəni tor deyirik.
Bunun vacib nəticəsi var: heç bir səhifədən keçid almayan səhifə körpüsü olmayan adaya bənzəyir. Robotun ora gedən yolu yoxdur. Buna görə sayt sahibləri Google-a xəritə də verir: sayt xəritəsi (sitemap), "mənim səhifələrim bunlardır" deyən siyahı.
Əksi də mümkündür. Sayt sahibi robots.txt adlı kiçik faylla robota "bu bölməyə girmə" deyə bilər; Google bu lövhəyə əməl edir. Tarama haqqında ətraflı öyrənmək istəyirsinizsə, crawling və robots.txt bələdçimizə baxın.
2. İndeksə əlavə: noindex və təkrarlanan səhifələr
Robot oxuduğu səhifəni gətirir və Google onu təhlil edir: səhifə nədən bəhs edir, başlığı nədir, hansı dildədir, içində şəkil və ya video var mı? Sonra səhifə indeksdəki yerinə yerləşir. Amma oxunan hər səhifə indeksə düşmür.
Səhifənin kodunda bir sətirlik işarə ola bilər: noindex. Mənası "məni oxuya bilərsən, amma indeksə qoyma" deməkdir. Sayt qurularkən qoyulan və sonra unudulan bu sətir üzündən səhifə illərlə yayımda dura və Google-da bir dəfə də görünməyə bilər. Bu, tez-tez rast gəlinən səhvlərdən biridir.
Bir də təkrar problemi var. Eyni səhifə saytda üç fərqli ünvanda dura bilər: "www" ilə, "www"-siz və ya sonunda kiçik əlavə ilə. Google onları ayrı-ayrı indeksə qoymur; onlardan birini əsas səhifə (kanonik URL) seçir, digərlərini onun surəti sayır. Seçimi sayt sahibi işarələyə bilər. İşarələməsə, seçimi Google edir və bəzən istəmədiyiniz ünvanı seçir.
Zaman da işin bir hissəsidir. Google-un yardım səhifələrinə görə yeni və ya dəyişmiş səhifənin taranması bir neçə gündən bir neçə həftəyə qədər çəkə bilər. Bu gün açılan saytın sabah səhər Google-da olmaması səhv deyil, sistemin özüdür.
3. Nəticələrin göstərilməsi: Google hansı səhifəni niyə yuxarı qoyur?
Axtar düyməsinə basdığınız an başlayan hissə budur. Google indeksinə baxır və sualınıza cavab verə biləcək səhifələri tapır; bəzən minlərlə, bəzən milyonlarla səhifə. Amma birinci yerdə yalnız biri dura bilər.
1996-dakı o iki tələbənin əsl kəşfi buradadır. Fikirləri belə idi: başqa səhifələrdən bir səhifəyə verilən hər keçid bir səs kimidir. Amma hər səs bərabər deyil; çox etibar edilən səhifənin səsi tanınmayan səhifənin səsindən ağır gəlir. Bu fikrin adı PageRank-dır; adını Larri Peycin soyadından alır. Google-u ilk illərində digər axtarış sistemlərindən fərqləndirən fikir bu idi.
Bu gün iş daha mürəkkəbdir. Google sıralamada çoxlu amili nəzərə aldığını deyir: sorğunuzun mənası, səhifənin mövzunu nə qədər yaxşı cavablandırdığı, səhifənin sürəti və telefonda düzgün açılıb-açılmadığı. Hətta siz: harada olduğunuz və hansı dildən istifadə etdiyiniz. Bakıda "kafe" yazan adamla Gəncədə eyni sözü yazan adam fərqli nəticələr görür.
Reklamla yuxarı çıxmaq olar mı? Süni intellekt xülasələri haradan qidalanır?
Səhifənin yuxarısında "Sponsorlu" yazılan nəticələr reklamdır və hərrac yolu ilə yer alır. Onların altındakı adi nəticələrdə isə Google-un izahına görə pulla sıra almaq olmur; reklam vermək adi sıralamaya təsir etmir. Yəni eyni səhifədə iki ayrı yarış var: biri büdcə ilə, digəri o üç mərhələ ilə qazanılır.
Son illərdə bəzi axtarışlarda, bəzi ölkələrdə nəticələrin ən yuxarısında süni intellektin yazdığı xülasə də çıxır. O xülasənin altında da mənbə keçidləri var: süni intellekt cavabı boşluqdan yaratmır, eyni indeksdən və eyni taranmış səhifələrdən qidalanır. İndeksdə olmayan səhifə o xülasədə də yer ala bilməz. Bu xülasələrin trafikə təsirini Google AI Overviews yazımızda ayrıca izah etmişik.
Google-un indeksi nə qədər böyüyüb?
Google-un 2008-ci ildə öz bloqunda yazdığına görə 1998-ci ildəki ilk indeksdə 26 milyon səhifə var idi. 2000-ci ildə indeks bir milyard səhifəyə çatdı. 2008-ci ildə isə Google-un sistemləri internetdə bir trilyon fərqli ünvan saymışdı. LEGO qutusunda başlayan o surət bu gün yüz milyardlarla səhifəni saxlayır.
Bəlkə də daha təəccüblü bir rəqəm var: Google-un izahına görə hər gün edilən axtarışların təxminən yüzdə 15-i əvvəllər heç vaxt edilməmiş axtarışlardır. İyirmi ildən artıqdır milyardlarla insan axtarış etsə də, hər gün yazılan axtarışların altıda birinə yaxını Google-un əvvəllər heç görmədiyi söz ardıcıllıqlarıdır. Google onlara da eyni indeksdən cavab çıxarır.
Saytınız Google-da varmı? Üç yolla yoxlayın
Bunu həyata gətirək. Gözəl saytı olan bir şirniyyat dükanı düşünün. Saytda unudulmuş noindex sətri varsa və ya səhifəyə heç bir yerdən keçid yoxdursa, Google üçün o dükan yoxdur: küçənin ortasında qapısı görünməyən mağaza kimi.
- site: axtarışı. Google-un axtarış qutusuna site: yazıb boşluq qoymadan saytınızın ünvanını əlavə edin (məsələn, site:numuneshirniyyat.az). Google indeksində o sayta aid tapdığı səhifələri sıralayır. Siyahı boşdursa və ya vacib səhifəniz yoxdursa, həmin səhifə üç mərhələdən birində ilişib qala bilər. Bu nəticə dəqiq say deyil, sürətli ipucudur.
- Search Console. Google-un sayt sahiblərinə verdiyi pulsuz alətdir. Saytınızı əlavə etdikdən sonra hansı səhifələrin indeksdə olduğunu, hansılarının niyə kənarda qaldığını görürsünüz. Yeni səhifə üçün tarama da istəyə bilərsiniz. Amma bu istək növbə nömrəsi kimidir; səhifənin dərhal indeksə düşəcəyi demək deyil.
- Pulsuz SEO yoxlama alətimiz. SEO yoxlama səhifəmizə (ingiliscə) səhifənizin ünvanını yazın. Alət səhifəni Google robotuna bənzər şəkildə oxuyur; noindex varmı, başlıq və təsvir yerindədirmi, səhifə telefona uyğundurmu, hamısını bir ekranda göstərir. Qeydiyyat tələb olunmur.
Tez-tez edilən səhv: WordPress kimi sistemlərdə sayt qurularkən "axtarış sistemlərinin bu saytı indeksləməsinə mane ol" seçimi açılır, sayt yayıma çıxanda onu bağlamaq unudulur. Səhifələrinizin heç biri site: axtarışında çıxmırsa, əvvəlcə buna baxın.
Növbəti bölüm: internet okeanın dibindən gəlir
Google cavabı tapdıqdan sonra o cavab telefonunuza necə gəlir? Çoxumuz internetin havada, buludda olduğunu düşünürük. Əslində böyük hissəsi okeanların dibindəki kabellərdən keçir. Ekranın Arxasının növbəti bölümündə o kabellərin izinə düşürük.
2-ci bölümü oxuyun: İnternet kəsilsə nə olar? Okeanın dibindəki 1,5 milyon kilometr
Mənbələr və əlaqəli səhifələr
- Google Search Central: Google Axtarış necə işləyir (ingiliscə)
- Google: Axtarış indeksi (yüz milyardlarla səhifə, 100 milyon GB-dan çox, ingiliscə)
- Google: Yenidən tarama istəyi (günlərdən həftələrə, ingiliscə)
- Google: Təkrarlanan səhifələr və kanonik URL (ingiliscə)
- Google: Axtarışda reklamlar (ingiliscə)
- Stenford: "Google" adının mənşəyi (ingiliscə)
- Google Blog (2008): indeksin böyüməsi (ingiliscə)
- Search Engine Land: axtarışların yüzdə 15-i yenidir (ingiliscə)
- Crawling nədir? robots.txt və E-E-A-T
- TurkWebSite YouTube kanalı: Ekranın Arxası seriyasının videoları (Türkiyə türkcəsində).
Saytınız Google-da görünür mü?
Səhifənizin ünvanını yazın, noindex, başlıq, təsvir və mobil uyğunluğu bir ekranda görün. Problem çıxsa, SEO paketlərimizlə birlikdə düzəldək.