Hvordan fungerer Google? Ett søks reise på ett sekund
Når du trykker på Søk, ser ikke Google på internett; den søker i sin egen kopi. Første episode av Bak skjermen: gjennomsøking, indeksering, rangering og tre måter å sjekke om nettstedet ditt er på Google.
Du skriver et spørsmål på telefonen, trykker på Søk, og svaret står på skjermen før det har gått ett sekund. De fleste av oss tror at Google i det sekundet farer gjennom hele internett for å finne det vi spurte om. Faktisk ser ikke Google på internett i det hele tatt i det øyeblikket. Svaret hentes fra Googles egen kopi, en kopi som har blitt lest og lagret i månedsvis.
Denne artikkelen er den skrevne versjonen av første episode av Bak skjermen (Ekranın Arkası), en serie på YouTube-kanalen vår. Hver episode ser på det virkelige maskineriet bak en teknologi vi bruker hver dag. Du kan se videoen eller bare lese videre. Illustrasjonene i artikkelen er scenene fra videoen. Selve videoen er på tyrkisk.
Kort fortalt:
- Når du søker, søker ikke Google på internett. Google søker i sin egen indeks, en kopi av sidene på nettet.
- En side må gjennom tre trinn før den kan vises i søk: gjennomsøking, indeksering og visning av resultater.
- En side som ikke er i indeksen, kan ikke finnes på Google, selv om den er publisert. De vanligste årsakene er en glemt noindex-linje eller en side som ingen andre sider lenker til.
- Du kan selv sjekke om nettstedet ditt er indeksert med et site:-søk og med Search Console.
Google søker ikke på internett når du søker
Det finnes hundrevis av milliarder sider på nettet. Hvis Google skulle åpne dem én etter én for hvert søk, ville svaret aldri kommet på ett sekund. Derfor gjør Google jobben på forhånd: den leser sidene, analyserer dem og lagrer dem i sitt eget arkiv. Dette arkivet kalles indeksen.
Tenk på stikkordregisteret bak i en bok. For å finne ordet «fotosyntese» leser du ikke boka fra perm til perm; du slår opp i registeret bakerst: fotosyntese, side 112. Det er akkurat det Google gjør. Den eneste forskjellen er at boka er selve internett.
Ifølge Googles egen forklaring inneholder denne indeksen hundrevis av milliarder nettsider og er langt over 100 000 000 gigabyte stor. Den setningen har en viktig konsekvens for alle som eier et nettsted: en side som ikke finnes i Googles kopi, finnes ikke for Google. Siden kan være publisert, den kan være pen, den kan være betalt for. Er den ikke i indeksen, finnes det ingen måte å finne den på i Google-søk.
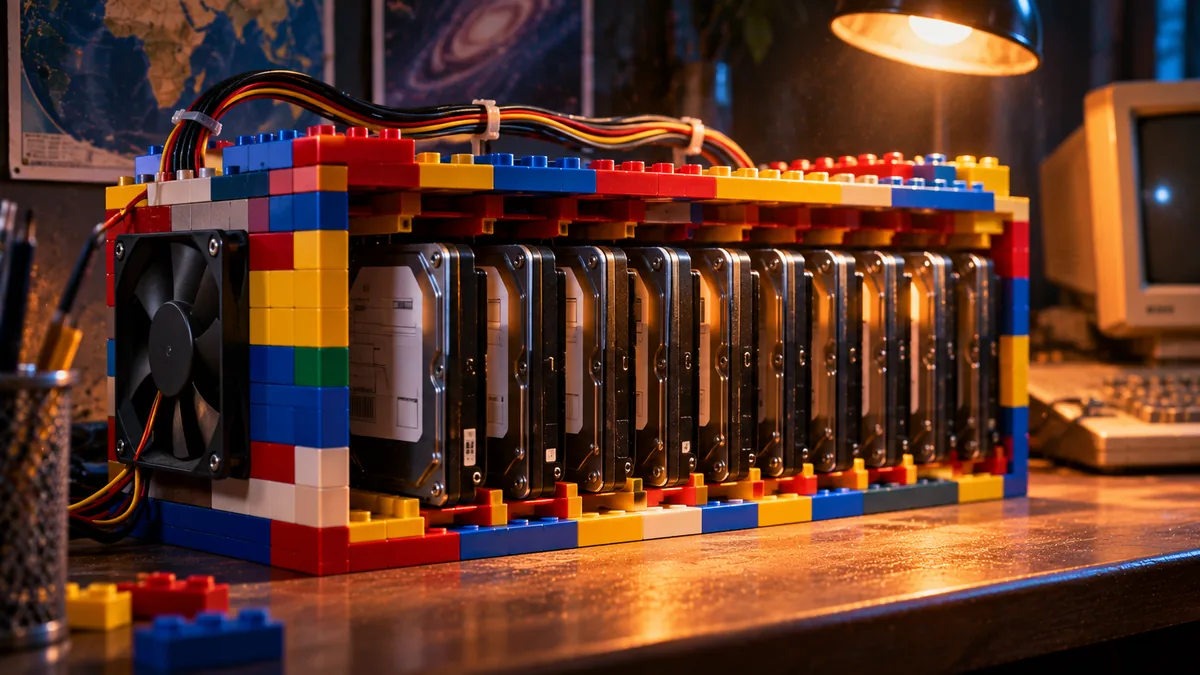
1996: en LEGO-boks, en googol og en garasje
Historien begynner i 1996 ved Stanford University i California. To doktorgradsstudenter, Larry Page og Sergey Brin, jobber med et forskningsprosjekt med et litt rart navn: BackRub. I stedet for et ferdig kabinett stiller de harddiskene sine opp i en boks bygd av LEGO-klosser. Den første versjonen av søkemotoren som milliarder av mennesker bruker i dag, gikk inne i fargerike lekeklosser.
Da prosjektet trenger et nytt navn, har de ordet googol i tankene: navnet på tallet du får når du skriver 1 med hundre nuller etter. Ifølge beretningen i Stanfords arkiv ble ordet feilstavet som «google» mens de sjekket om domenenavnet var ledig. De likte skrivemåten, og den ble stående. Domenet google.com ble registrert 15. september 1997. I 1998 ble selskapet stiftet, og det første kontoret var garasjen i et leid hus i Menlo Park.
Problemet de to studentene løste, står fortsatt i sentrum hos Google i dag. For å forstå det, la oss se på de tre jobbene Google gjør hver dag.
Googles tre trinn: gjennomsøking, indeksering, visning
Dokumentasjonen fra Google Search Central deler søk inn i tre trinn. Hver side går gjennom dem i rekkefølge; en side som blir stående fast i ett av dem, vises ikke i søk.
1. Gjennomsøking: hvordan finner Googlebot sider?
Google har et program som heter Googlebot. Tenk på det som en leser som vandrer rundt på internett: den åpner en side, leser den, noterer lenkene på siden og går videre til neste. Det er derfra edderkopp-bildet kommer, og derfor kaller vi internett et «web», altså et nett.
Dette har en viktig konsekvens: en side som ingen andre sider lenker til, er som en øy uten bro. Roboten har ingen vei dit. Derfor gir nettstedseiere også Google et kart: et områdekart (sitemap), en liste som sier «dette er sidene mine».
Det motsatte går også. Med en liten fil som heter robots.txt kan nettstedseieren si til roboten «ikke gå inn i denne delen», og Google respekterer skiltet. Vil du vite mer om gjennomsøking, kan du lese guiden vår om crawling og robots.txt.
2. Indeksering: noindex og dupliserte sider
Roboten tar med seg siden den har lest, og Google analyserer den: hva handler siden om, hva er tittelen, hvilket språk er den på, har den bilder eller video? Så får siden sin plass i indeksen. Men ikke alle sider som leses, kommer inn i indeksen.
Koden til en side kan inneholde en markering på én linje: noindex. Den betyr «du kan lese meg, men ikke legg meg i indeksen». På grunn av denne ene linjen, lagt inn mens nettstedet ble bygd og så glemt, kan en side være publisert i årevis uten å vises på Google én eneste gang. Det er en vanlig feil.
Så har vi duplikatproblemet. Den samme siden kan ligge på tre ulike adresser på et nettsted: med «www», uten «www» eller med et lite tillegg på slutten. Google indekserer dem ikke hver for seg; den velger én som hovedside (kanonisk nettadresse) og regner de andre som duplikater. Nettstedseieren kan markere den foretrukne. Gjør du ikke det, velger Google, og noen ganger velger den en adresse du ikke ønsket.
Tid er også en del av det. Ifølge Googles hjelpesider kan gjennomsøking av en ny eller endret side ta alt fra noen dager til noen uker. At et nettsted som ble lansert i dag, ikke er på Google i morgen tidlig, er ingen feil; det er slik systemet fungerer.
3. Visning av resultater: hvorfor havner én side øverst?
Dette er delen som starter idet du trykker på Søk. Google ser i indeksen og finner sidene som kan svare på spørsmålet ditt: noen ganger tusenvis, noen ganger millioner. Men bare én kan stå på førsteplass.
Her kommer den egentlige oppfinnelsen til de to studentene fra 1996. Ideen var: hver lenke fra en annen side til en side er som en stemme. Men ikke alle stemmer er like; en stemme fra en side man stoler mye på, veier tyngre enn en fra en ukjent side. Ideen heter PageRank, oppkalt etter etternavnet til Larry Page. Det var den ideen som skilte Google fra andre søkemotorer de første årene.
I dag er det langt mer sammensatt. Google sier at den tar hensyn til mange faktorer når den rangerer: betydningen av søket ditt, hvor godt siden svarer, hvor rask siden er og om den fungerer skikkelig på mobil. Til og med deg: hvor du er og hvilket språk du bruker. Den som skriver «kafé» i Oslo, ser andre resultater enn den som skriver det samme i Bergen.
Kan man betale seg til topps? Hvor kommer KI-sammendragene fra?
Resultatene merket «Sponset» øverst på siden er annonser, og plassen deres avgjøres i en auksjon. I de vanlige resultatene under dem kan du ifølge Google ikke kjøpe deg en plassering; annonsering påvirker ikke den vanlige rangeringen. Det er altså to separate løp på samme side: det ene vinnes med budsjett, det andre gjennom de tre trinnene.
De siste årene har det også dukket opp et KI-skrevet sammendrag øverst i resultatene for noen søk og i noen land. Under sammendraget finnes det kildelenker: KI-en finner ikke på svaret fra ingenting, den henter fra den samme indeksen og de samme gjennomsøkte sidene. En side som ikke er i indeksen, kan heller ikke være med i sammendraget. Hvordan disse sammendragene påvirker trafikken, har vi skrevet om i artikkelen om Google AI-oversikter.
Hvor stor har Googles indeks blitt?
Ifølge Googles egen blogg fra 2008 inneholdt den første indeksen i 1998 26 millioner sider. I 2000 hadde den nådd én milliard sider. Og i 2008 hadde Googles systemer telt én billion unike adresser på nettet. Kopien som startet i en LEGO-boks, rommer i dag hundrevis av milliarder sider.
Kanskje er det et enda mer overraskende tall: ifølge Google er omtrent 15 prosent av søkene som gjøres hver dag, søk som aldri er gjort før. Selv om milliarder av mennesker har søkt i over tjue år, er nesten hvert sjette søk som skrives hver dag, en ordrekke Google aldri har sett. Google svarer på dem også fra den samme indeksen.
Er nettstedet ditt på Google? Tre måter å sjekke på
La oss ta dette inn i hverdagen. Se for deg et bakeri med et fint nettsted. Hvis nettstedet fortsatt har en glemt noindex-linje, eller ingen sider lenker til det, finnes ikke bakeriet for Google: som en butikk midt i gata der du ikke ser døra.
- Et site:-søk. Skriv site: i Googles søkefelt etterfulgt av domenet ditt uten mellomrom (for eksempel site:eksempelbakeri.no). Google lister sidene fra det nettstedet som ligger i indeksen. Er lista tom, eller mangler en viktig side, kan siden stå fast i ett av de tre trinnene. Dette er ikke en nøyaktig telling, bare et raskt hint.
- Search Console. Googles gratisverktøy for nettstedseiere. Når du har lagt til nettstedet, ser du hvilke sider som er i indeksen og hvorfor andre er utelatt. Du kan også be om gjennomsøking av en ny side. Men forespørselen er som en kølapp; den betyr ikke at siden blir indeksert med en gang.
- Vårt gratis SEO-verktøy. Skriv inn sideadressen på SEO-sjekksiden vår (på engelsk). Verktøyet leser siden omtrent slik Googles robot gjør, og viser på én skjerm om det finnes noindex, om tittel og beskrivelse er på plass og om siden er mobilvennlig. Ingen registrering.
En vanlig feil: i systemer som WordPress slås valget «be søkemotorer om ikke å indeksere dette nettstedet» på mens nettstedet bygges, og ingen slår det av ved lansering. Hvis ingen av sidene dine vises i et site:-søk, sjekk dette først.
Neste episode: internett kommer fra havbunnen
Når Google har funnet svaret, hvordan kommer det fram til telefonen din? De fleste av oss tror internett befinner seg i lufta, i skyen. I virkeligheten går mesteparten gjennom kabler på havbunnen. I neste episode av Bak skjermen følger vi de kablene.
Les episode 2: Hva skjer hvis internett går ned? 1,5 millioner kilometer på havbunnen
Kilder og relaterte sider
- Google Search Central: Slik fungerer Google Søk (gjennomsøking, indeksering, visning)
- Google: Søkeindeksen (hundrevis av milliarder sider, over 100 000 000 GB)
- Google: Be Google om å gjennomsøke nettadresser på nytt (dager til uker)
- Google: Dupliserte sider og kanoniske nettadresser
- Google: Annonser i Søk
- Stanford: opprinnelsen til navnet «Google» (engelsk)
- Google Blog (2008): indeksens vekst (engelsk)
- Search Engine Land: 15 prosent av søkene er nye (engelsk)
- Hva er crawling? robots.txt, E-E-A-T og KI-SEO
- TurkWebSite på YouTube: videoene i Bak skjermen (på tyrkisk).
Vises nettstedet ditt på Google?
Skriv inn sideadressen og se noindex, tittel, beskrivelse og mobilvennlighet på én skjerm. Er noe galt, kan vi rette det sammen med SEO-pakkene våre.